RTX 3090 สองใบจับคู่ Intel Optane รัน AI Kimi K3 ขนาด 2.8 ล้านล้านพารามิเตอร์ได้ 3.11 Tokens/sec
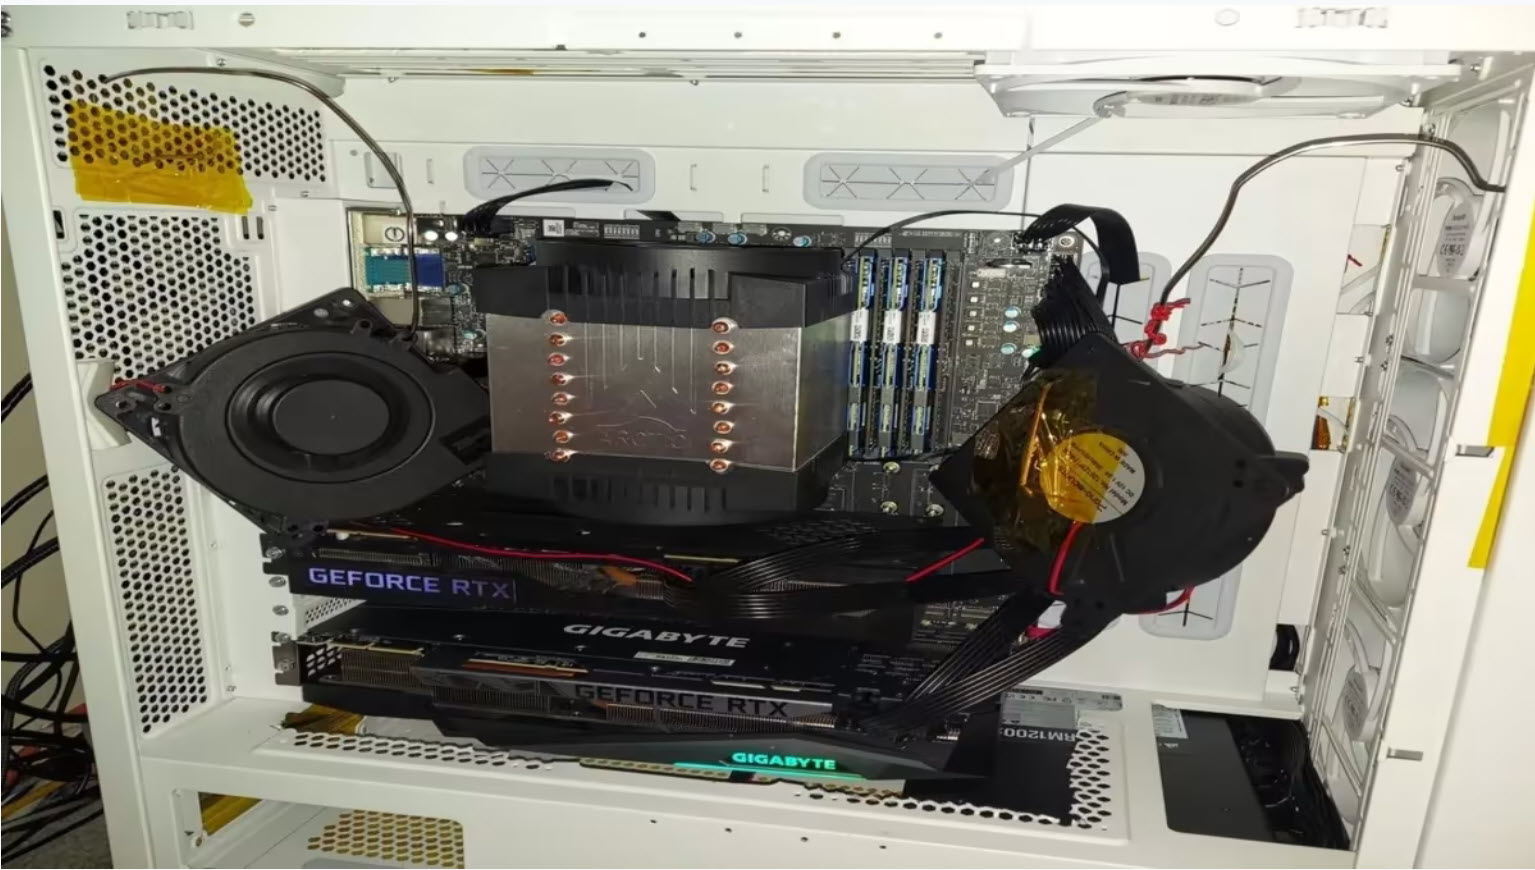
การรันโมเดล AI ขนาดใหญ่บนคอมพิวเตอร์ส่วนบุคคลยังเป็นเรื่องท้าทาย โดยเฉพาะโมเดลที่ต้องใช้หน่วยความจำจำนวนมหาศาล แต่ล่าสุดมีผู้ใช้งานรายหนึ่งทดลองนำการ์ดจอ NVIDIA GeForce RTX 3090 จำนวน 2 ใบ มาทำงานร่วมกับ Intel Xeon และหน่วยความจำ Intel Optane เพื่อรัน Kimi K3 โมเดล AI จาก Moonshot AI ที่มีขนาดถึง 2.8 ล้านล้านพารามิเตอร์ได้สำเร็จ
ใช้หน่วยความจำหลายรูปแบบเพื่อรองรับโมเดลขนาดใหญ่
แม้ RTX 3090 ทั้งสองใบจะมี VRAM รวมกัน 48GB แต่ยังไม่เพียงพอสำหรับจัดเก็บโมเดล Kimi K3 ที่มีขนาดประมาณ 865GB ในรูปแบบ Quantized Q2_K
ระบบจึงใช้แนวทาง Hybrid CPU-GPU ผ่าน llama.cpp โดยแบ่งการทำงานระหว่าง GPU, RAM และ Intel Optane เพื่อรองรับน้ำหนักโมเดลที่มีขนาดใหญ่กว่าหน่วยความจำบนการ์ดจอหลายเท่า
ในการทดสอบครั้งแรก มีการจัดเก็บโมเดลทั้ง 94 Shards ไว้บน Intel Optane ทำความเร็วในการสร้างข้อความได้ 2.20 Tokens/sec และประมวลผล Prompt ได้ 13.3 Tokens/sec
ย้ายข้อมูล 414GB ไปยัง RAM Drive เพิ่มความเร็ว 41%
จุดเปลี่ยนสำคัญของการทดลองคือการย้ายข้อมูลโมเดลจำนวน 45 Shards หรือประมาณ 414GB ไปเก็บไว้ใน RAM Drive บน Linux (tmpfs) ขณะที่ข้อมูลอีก 49 Shards รวมประมาณ 451GB ยังคงอยู่บน Intel Optane
ผลลัพธ์คือความเร็วในการสร้างข้อความเพิ่มขึ้นเป็น 3.11 Tokens/sec หรือเร็วขึ้นประมาณ 41% ส่วนความเร็วในการประมวลผล Prompt เพิ่มขึ้นเป็น 16.8 Tokens/sec หรือประมาณ 26%
ผลดังกล่าวสะท้อนให้เห็นว่าการลดภาระการอ่านข้อมูลจากหน่วยความจำที่ช้ากว่า และย้ายข้อมูลบางส่วนมาไว้ใน RAM สามารถช่วยเพิ่มประสิทธิภาพของระบบได้อย่างชัดเจน โดยไม่จำเป็นต้องเพิ่มจำนวน GPU
Kimi K3 มี 2.8 ล้านล้านพารามิเตอร์ แต่เปิดใช้งานเพียงบางส่วน
Kimi K3 ใช้สถาปัตยกรรม Mixture of Experts (MoE) ซึ่งแม้จะมีพารามิเตอร์รวมถึง 2.8 ล้านล้าน แต่จะเปิดใช้งานพารามิเตอร์เพียงบางส่วนในแต่ละ Token โดยมี Active Parameters ประมาณ 104 พันล้านพารามิเตอร์ต่อ Token
ลักษณะการทำงานนี้ช่วยให้โมเดลขนาดใหญ่มากสามารถแบ่งภาระการประมวลผลได้ โดยไม่จำเป็นต้องใช้พารามิเตอร์ทั้งหมดพร้อมกันในทุกขั้นตอน
ข้อจำกัดด้านความร้อนและความเร็ว
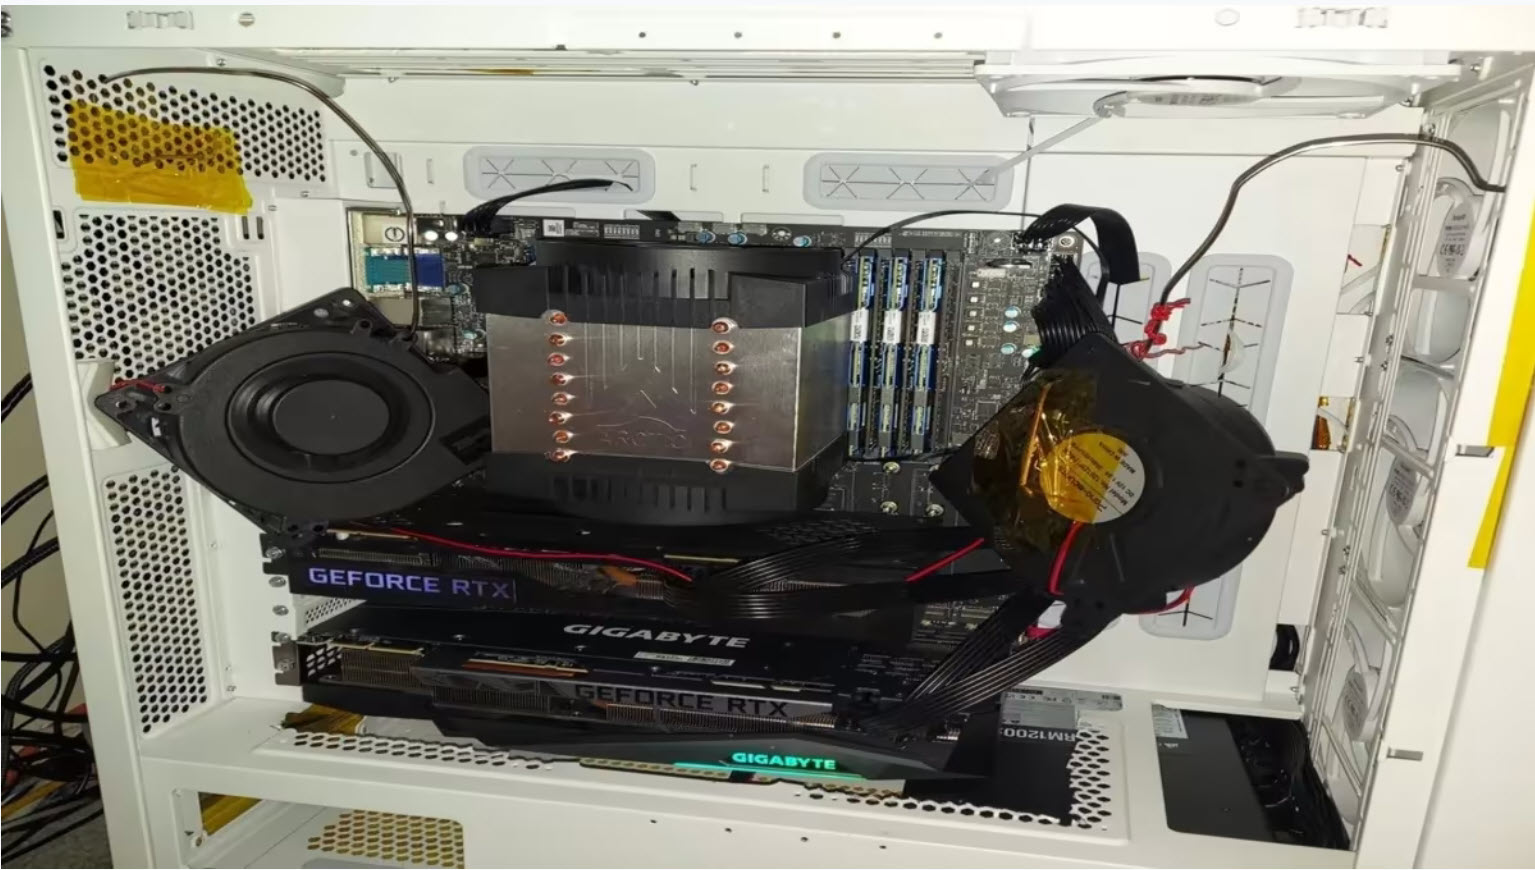
อย่างไรก็ตาม การประกอบระบบดังกล่าวไม่ได้มีเพียงเรื่องหน่วยความจำเท่านั้น ผู้ทดลองต้องดัดแปลงเคสคอมพิวเตอร์และย้ายตำแหน่ง Power Supply เพื่อให้ติดตั้งอุปกรณ์ได้ทั้งหมด
นอกจากนี้ Intel Optane DIMM ยังต้องได้รับการระบายความร้อนโดยใช้พัดลมแบบ Blower ขนาด 12W จำนวนสองตัวเป่าตรงไปยังหน่วยความจำ และผู้ทดลองยังเตือนว่าความร้อนสะสมจากการทำงานต่อเนื่องอาจส่งผลกระทบต่อ DRAM ที่อยู่ใกล้เคียงได้
แม้จะสามารถรันโมเดล AI ขนาด 2.8 ล้านล้านพารามิเตอร์ได้จริง แต่ความเร็ว 3.11 Tokens/sec ยังถือว่าค่อนข้างต่ำสำหรับการใช้งาน AI ทั่วไป ซึ่งโดยสรุปแล้วการทดลองนี้เป็นการแสดงให้เห็นถึงศักยภาพของการนำ GPU รุ่นเก่า หน่วยความจำ RAM และ Intel Optane มาทำงานร่วมกันเพื่อรองรับโมเดล AI ที่มีขนาดใหญ่เกินกว่าความจุ VRAM ของการ์ดจอ
ที่มา: Reddit